Как AI-поиск выбирает источники и почему в GEO недостаточно оптимизировать только свой сайт
Опубликовано: 28.10.2026
126
12 мин
Рассказали, почему GEO – это не набор лайфхаков для отдельных страниц, а комплекс из внутренней релевантности сайта и внешнего контура бренда.
В GEO сейчас много конкретных рекомендаций: добавить разметку, вынести прямой ответ в начало страницы, создать специальный файл, изменить структуру текста. Но эти точечные рекомендации срабатывают только тогда, когда понятна общая механика: как языковая модель вообще доходит до конкретного документа и решает, что его стоит использовать?
Мы разобрались, что работает комплекс: внутренняя релевантность плюс поисковое присутствие. Если бренд не представлен во внешних источниках, даже сильную страницу ИИ может не заметить. Чтобы это понять, мы сначала экспериментировали с локальной LLM, затем собрали собственную симуляцию AI-поиска, а после сопоставили свои наблюдения с внешними исследованиями. Подробнее рассказываем в статье.
Эксперимент: локальная система поиска на LLM
Чтобы понять, как поисковый контур выбирает источники из массива данных, мы развернули локальную модель Qwen, построили на ней систему поиска по корпусу патентов Google и Яндекса.
-
Сначала документы хранились крупными массивами по 5–10 тыс. знаков, и результат поиска оказался нестабильным.
-
Релевантная информация могла находиться сразу в нескольких документах, а при одинаковом вопросе система выбирала разные источники.
-
Тогда документы разбили на более мелкие фрагменты — чанки — и добавили отдельный этап ранжирования по релевантности запросу.
-
После этого качество поиска и итоговых ответов улучшилось.
Практический вывод: передавать модели весь доступный массив данных необязательно. Эффективнее сначала отобрать небольшой набор наиболее релевантных фрагментов, а уже затем использовать их для формирования ответа. Факты о бренде, упакованные в короткие самодостаточные фрагменты, имеют больше шансов попасть в выборку.
Что будет, если перенести ту же задачу на веб-поиск
Дальше мы собрали симуляцию AI-ответа из двух компонентов, как в реальности: поисковая выдача плюс настоящая LLM по API. Посмотрели, как это работает.
Промпт «Где купить спецодежду в Москве?» раскладывается на несколько веерных запросов («Где купить зимнюю спецодежду в Москве?», «Где купить спецодежду в Москве для сварщика?» и т. п.). Методика веерных запросов описана в справке Google по оптимизации сайта для ИИ функций. Метод позволяет собирать информацию по связанным темам из разных источников и на этой основе формировать более полный ответ.
По каждому из веерных запросов поиск собирает, например, топ-10 страниц. Если запросов пять, это около 50 страниц. Для бренда означает, что если информация о нем есть только на сайте, для AI-ответа этого недостаточно – нужны упоминания на других доменах.
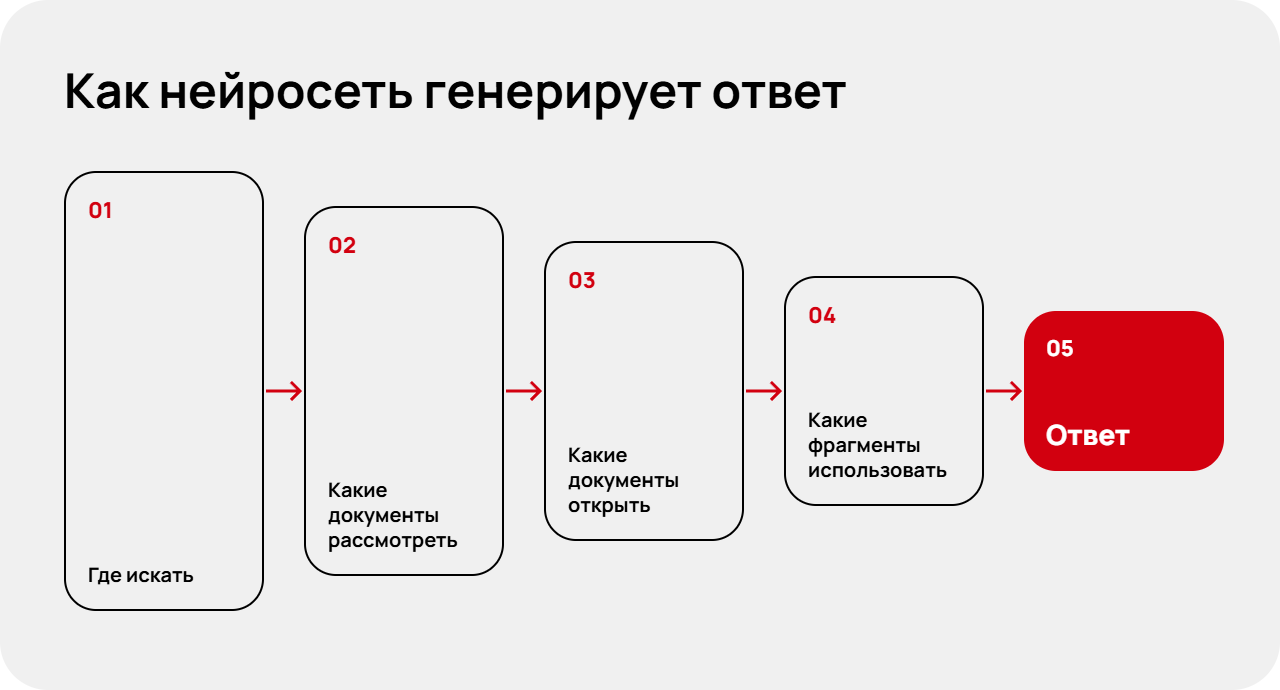
Полная обработка всех найденных страниц потребует слишком много ресурсов, токенов и времени. Поэтому логично предположить, что сначала идет сокращение исходной выборки.
Что происходит между выдачей и чтением страницы
До открытия страницы retrieval контур уже знает ее позицию, домен, URL, title, сниппет — в общем, довольно много информации. Поэтому появилась гипотеза: сначала ИИ может быстро оценить кандидатов по этим данным и только потом погрузиться в небольшую часть документов. В собственной симуляции из пункта 2 мы так и сделали: выбирали слой примерно из 10–20 наиболее релевантных страниц, и только после этого система загружала их содержимое.
Посмотрим, что показал обратный инжиниринг ChatGPT, который провело независимое агентство Resoneo.
-
Между получением списка результатов из поискового индекса и потенциальным открытием документов ChatGPT, по всей видимости, есть промежуточный этап оценки.
-
Этот косвенный вывод исследователей основан на том, что ответ может быть сгенерирован даже без открытия документов.
-
Очевидно, оценка найденных источников и формирование ответа могут происходить на основе уже доступных данных: URL, домена, заголовка и сниппета.
-
ChatGPT открывает не весь полученный список документов и может вообще ни один из них не открыть.
Общее между нашей симуляцией и результатами обратного инжиниринга это не количество скачиваемых документов, а то, что для формирования ответа модели не обязательно открывать все найденные документы.
Бронюс Велмунскас, ведущий специалист по поисковой оптимизации «Ашманов и партнеры»:
«Моя гипотеза. Я связываю ее с наблюдением из исследования Resoneo, где некоторые более новые модели получали меньше поисковых результатов и реже открывали документы, чем модель, с которой их сравнивали. Мое предположение: LLM может быть достаточно небольшого объема найденной информации, чтобы за счет собственных знаний сформировать ответ. Если собственных знаний и полученной информации недостаточно, например, сведения требуют уточнения на дату обращения, тогда система может открыть конкретный источник из поисковой выборки (полученного индекса)».
Делаем вывод:
-
далеко не для каждого найденного результата ИИ открывает полный документ;
-
до открытия он видит URL, title и сниппет, которые может использовать для ответа;
-
выбор страниц и полное чтение страницы — не один и тот же этап генерации;
-
внешние источники формируют пул кандидатов и сами данные для ответа.
Почему из этого не следует, что основную информацию надо уместить в первые 200 символов текста
Идея про первые 200 символов — упрощение. Она родилась из того, что, действительно, у ChatGPT сниппет имеет приблизительно такой размер. Но у собственного поискового индекса OpenAI и, например, поиска Google механика формирования сниппетов отличается.
-
В OpenAI так называемый Labrador-сниппет действительно составляет примерно 202 символа. Но он сформирован не из метатега description, а из начала отрендеренного основного текста и иногда H1. При этом одна и та же страница по разным запросам обычно возвращает один и тот же сохраненный сниппет.
-
В Google средняя длина сниппета составляет около 159 символов. При этом Google официально указывает, что сниппет подбирается под конкретный поисковый запрос, в том числе веерный. Поэтому для одной и той же страницы сниппет может отличаться в зависимости от запроса.
Таким образом, ответить на весь веер запросов одним первым абзацем невозможно. Каждый тематический блок должен самодостаточно отвечать на свой подинтент. Такие самодостаточные блоки нужны не только на сайте, но и на внешних площадках — в обзорах, статьях, снятии возражений. Задача первого абзаца — обозначить основную проблему через понятное вступление.
Как на самом деле продвигать сайт в ИИ
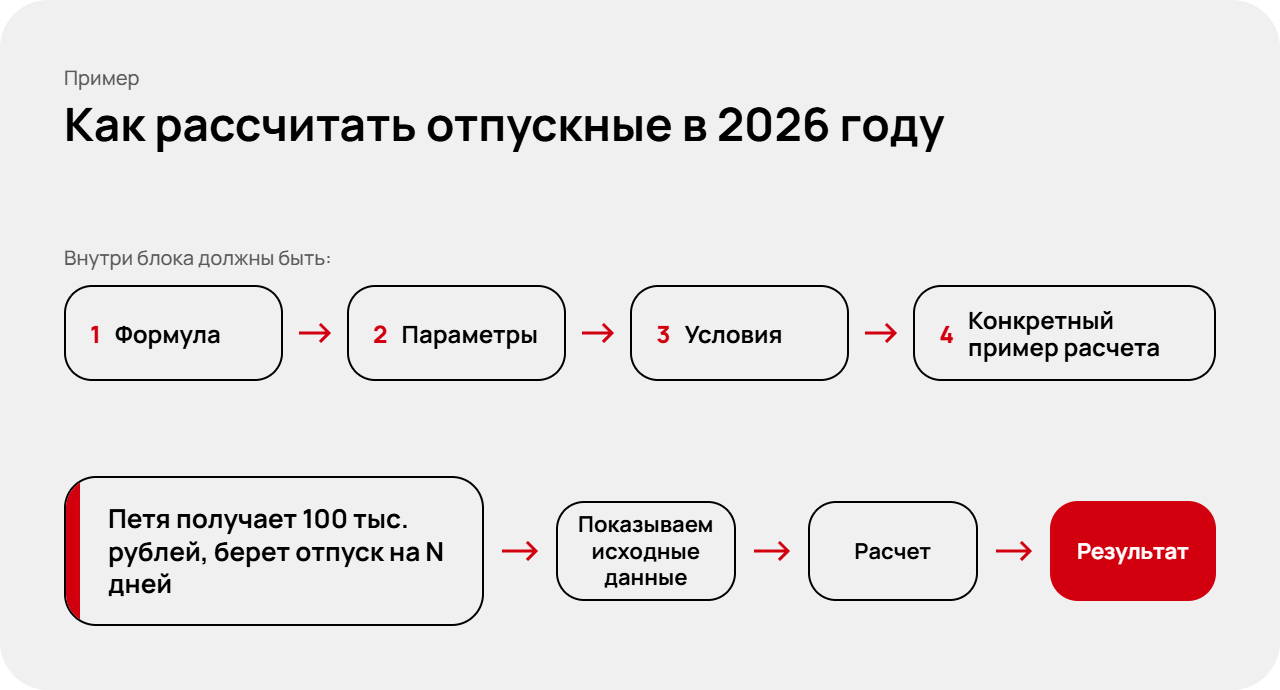
Самый эффективный способ — подавать информацию через триплеты. Триплет — это связка из трех элементов: субъект (кто/что) → предикат (что делает/какое свойство) → объект (с кем/чем или на что направлено действие).
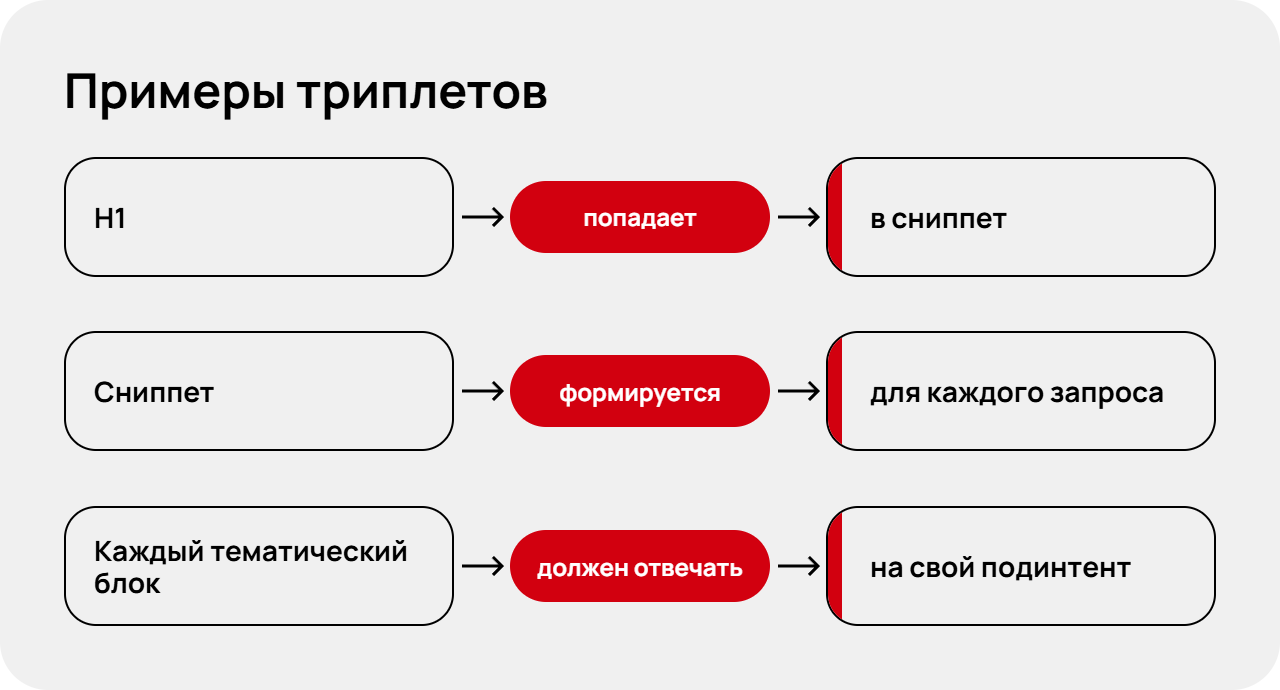
Для нейросетей и поисковых систем триплеты — базовая форма хранения информации. Если одна и та же связка регулярно встречается в разных источниках, поисковый контур начинает воспринимать ее как устоявшийся факт и с большей вероятностью включать в ответ.
Если статья имеет структуру, экспертизу, полно раскрывает основной интент и подинтенты, то внутри нее естественным образом появляются сущности, характеристики и значения. Именно поэтому мы рассматриваем триплеты не как отдельную технологию, а как один из способов формализовать обычную работу с релевантностью.
Как работать с коммерческими кластерами
Выше мы говорили в большей степени про информационные кластеры. Продукту, который продается, важно одновременно присутствовать во всех возможных плоскостях: как в коммерческой, так и в информационной.
Предположим, пользователь задает ИИ промпт: «Какую обувь лучше купить сварщику для работы на Крайнем Севере?».
Такой промпт может быть разбит на веер запросов:
-
обувь сварщика для Крайнего Севера;
-
зимняя спецобувь для сварщика;
-
требования к обуви сварщика;
-
спецобувь для работы при низких температурах;
-
температура эксплуатации зимней спецобуви;
-
защита обуви сварщика от искр и расплавленного металла;
-
какую зимнюю обувь выбрать сварщику.
То есть изначально коммерческий промпт может быть разложен на набор запросов, среди которых будут не только коммерческие, но и информационные.
Поэтому, чтобы увеличить долю бизнеса в ИИ ответе, необходимо:
-
Для коммерческого кластера: создать релевантные посадочные страницы с учетом поискового спроса и интента. Например, категории каталога «Обувь для сварщика», «Теплая обувь для сварщика». Не рекомендуем делать малоценные страницы под каждый веерный запрос. Если вопрос можно закрыть отдельным блоком на существующей странице, новую создавать не нужно.
-
Для информационного кластера: статьи, где максимально полно раскрыт интент. Например, «Какую обувь и одежду выбрать сварщику», где рассматривается выбор экипировки для разных условий эксплуатации: лето, зима, южные регионы, Крайний Север. Если существует отдельный поисковый спрос на тему «Как выбрать теплую обувь или одежду для сварщика», под этот спрос также должна быть отдельная информационная статья.
Важно не только само наличие таких документов на сайте, но и их высокое ранжирование в поисковой выдаче. Коммерческие и информационные подинтенты нужно закрывать также на сторонних сайтах, которые ИИ подтягивает по вееру запросов.
Главная проблема GEO находится за пределами страницы
Ваша страница может быть хорошо проработана, но какова вероятность, что система увидит именно ваш бренд среди кандидатов? Во многом это зависит от присутствия в поисковом пространстве.
ИИ может использовать разные типы источников в зависимости от задачи:
-
обычную поисковую выдачу;
-
собственный поисковый индекс ИИ-сервиса (если он есть);
-
новостные сайты и агрегаторы;
-
карты и организации;
-
товарные данные;
-
форумы и UGC;
-
специализированные или научные источники.
Значит, присутствовать только на собственном сайте недостаточно — необходимо транслировать нарратив про бренд, товары и услуги в разных источниках. Например, в обзорах, отзывах, обсуждениях и других полезных материалах на внешних площадках.
Расширенная стратегия внешнего GEO включает классический линкбилдинг как инструмент внешней SEO-оптимизации, а также PR, ORM/GERM, контент-маркетинг, SMM. Они распределяют бренд по разным типам источников и увеличивают его поисковое присутствие.
Почему крупным брендам проще попадать в AI-ответы
Крупный бренд обычно уже десятилетиями имеет заметный цифровой след в поисковом пространстве. Поэтому у него больше потенциальных точек касания с ИИ в тех источниках, которым он доверяет. Например, нейросеть скорее упомянет Сбер, чем условный Ярославльбанк, потому что у Сбера несравнимо выше поисковое присутствие. Как правило, у такого бренда есть:
-
высокий охват в поиске;
-
публикации в СМИ;
-
обратные ссылки;
-
присутствие в обзорах, рейтингах, каталогах;
-
отзывы на разных ресурсах;
-
обсуждения, форумы;
-
UGC;
-
упоминания экспертами.
Накопленный цифровой след играет на руку бренду, потому что публикации, обзоры, обсуждения и другие сведения о бренде могли попасть в обучающие данные LLM. Крупная компания могла быть известна модели еще до обращения к поиску за счет знаний, полученных при обучении.
Если говорить о попадании в обучающие данные LLM, работа над цифровым следом — это во многом инвестиция в будущую видимость бренда, чем результат здесь и сейчас. Однако можно получить и быстрый результат, если новые обзоры, публикации и обсуждения используются как источники для текущих AI ответов.
Важно, что небольшие компании получают неплохую видимость по нишевым промптам. Известному бренду проще попасть в ответ при широком запросе. При очень конкретном длинном запросе у нишевого экспертного бренда гораздо больше шансов.
Как строить GEO по двум контурам: план действий
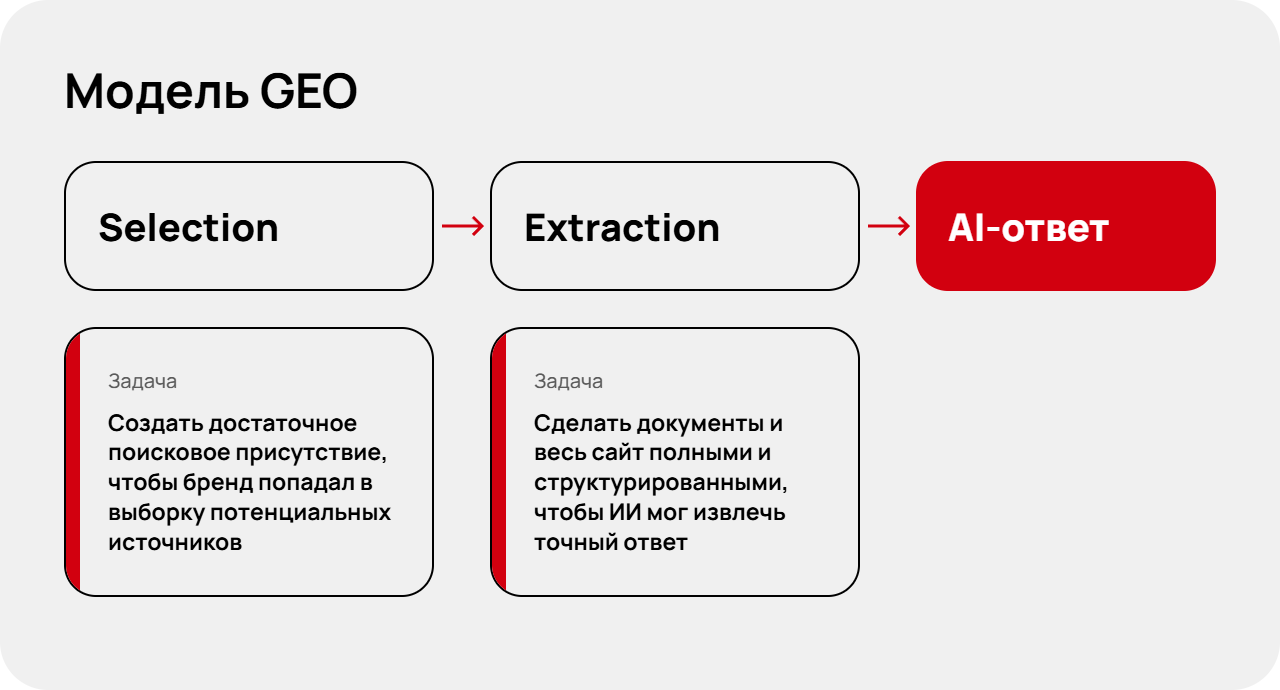
Подытожим. Стратегия GEO должна работать в двух контурах:
-
Selection — страница попадает в выборку.
-
Extraction — контент дает ИИ готовый материал для ответа.
Что делать на каждом этапе?
Контур Selection — выборка
Задача: увеличить вероятность того, что бренд или его документ вообще окажется среди кандидатов. Для этого нужно создать достаточное поисковое присутствие, чтобы бренд попадал в выборку потенциальных источников. Проверьте и проработайте:
-
поисковую видимость сайта и целевых страниц;
-
наличие внешних публикаций;
-
присутствие в СМИ, на форумах;
-
UGC;
-
отзывы;
-
каталоги;
-
упоминания и их тональность;
-
релевантные обратные ссылки;
-
присутствие в поиске по запросам с узким интентом.
Важно: оптимизировать нужно не только страницу, но и путь до нее.
Контур Extraction — материал для ответа
Задача: сделать нужные сведения легко извлекаемыми из выбранного источника. Нужен полный и структурированный контент, из которого можно взять точный ответ. Для этого проработайте на сайте:
-
полное раскрытие интента;
-
понятную структуру с учетом триплетов, подзаголовков Н1–Н3 и т. п.;
-
самостоятельные смысловые блоки;
-
факты;
-
сущности, характеристики и значения;
-
цифры;
-
примеры;
-
доступный для парсинга контент.
Важно: работайте не только с отдельными документами, но и со всем сайтом. Теперь недостаточно иметь отдельную страницу с номинальным ответом — потенциальный вопрос пользователя должен быть полноценно закрыт на хосте (домене).
Сам документ (страница), который вы хотите сделать источником для нейросетей, должен быть действительно полезным и релевантным запросу. Косвенным сигналом такой полезности можно считать высокое ранжирование в поисковом индексе. Если документы стабильно занимают высокие позиции, это обычно означает, что они достаточно релевантны и полезны.
Фокус на главное
1. Видимость бренда в AI-ответах складывается из двух контуров: попадание бренда в выборку ИИ и предоставление готового ответа на странице плюс закрытие интента пользователя на сайте. Поэтому GEO нельзя свести ни к «ответу в первом абзаце», ни к разметке, ни к закупке ссылок.
2. Необходимо присутствие на площадках, которым доверяет LLM. Распределяйте бренд по внешним площадкам через линкбилдинг, PR, ORM/GERM, контент-маркетинг, SMM, работу с отзывами и UGC.
3. Оптимизируйте не только сайт, но и поисковое пространство. Нейросеть не открывает все найденные страницы, сначала она сокращает выборку до релевантных авторитетных документов. Важно попасть в их число, и только страниц с сайта для этого недостаточно.
4. Первый абзац не закроет все подинтенты и веерные запросы. Сделайте каждый тематический блок самодостаточным. В первом абзаце обозначьте проблему, а точные ответы дайте в отдельных смысловых блоках.
5. Упаковывайте контент в триплеты: субъект → предикат → объект. Так текст обогащается фактами, сущностями, характеристиками, цифрами. Это повышает шанс, что фрагмент попадёт в AI-ответ.
6. Закрывайте коммерческие кластеры вместе с информационными. Коммерческий промпт часто раскладывается на веер запросов, среди которых есть и информационные. Создавайте и коммерческие посадочные страницы, и информационные статьи под подинтенты.
Знания на вашу почту!
Получайте одно письмо в месяц с лучшими статьями от экспертов «Ашманов и партнеры».
Нажимая на кнопку «Подписаться», я даю согласие на обработку персональных данных и соглашаюсь с политикой конфиденциальности.
Что в статье:
Знания на вашу почту!
Получайте одно письмо в месяц с лучшими статьями от экспертов «Ашманов и партнеры».
Нажимая на кнопку «Подписаться», я даю согласие на обработку персональных данных и соглашаюсь с политикой конфиденциальности.

Последние статьи эксперта:
Читайте по теме

Рассказываем, что на самом деле происходит с трафиком и как бизнесу адаптироваться к новой реальности с помощью оптимизации поискового пространства (SSO).
27.02.2026
3 899
6 мин
Рассказали, для какого бизнеса стратегия продвижения в нейросетях и нейроблоках менее эффективна, а кто получит от нее наибольший профит.
26.09.2025
6 074
8 мин
Как получать трафик, если поисковая система дает все ответы прямо в выдаче?
41 245
16 мин